大家好,我是一言,继续更新 Spring AI 2.0 系列。
前面几篇,我们一直在聊资料入库后怎么检索。这次往前走一步:售后规则放在 PDF、Word 里,怎样让 RAG 用上它们?
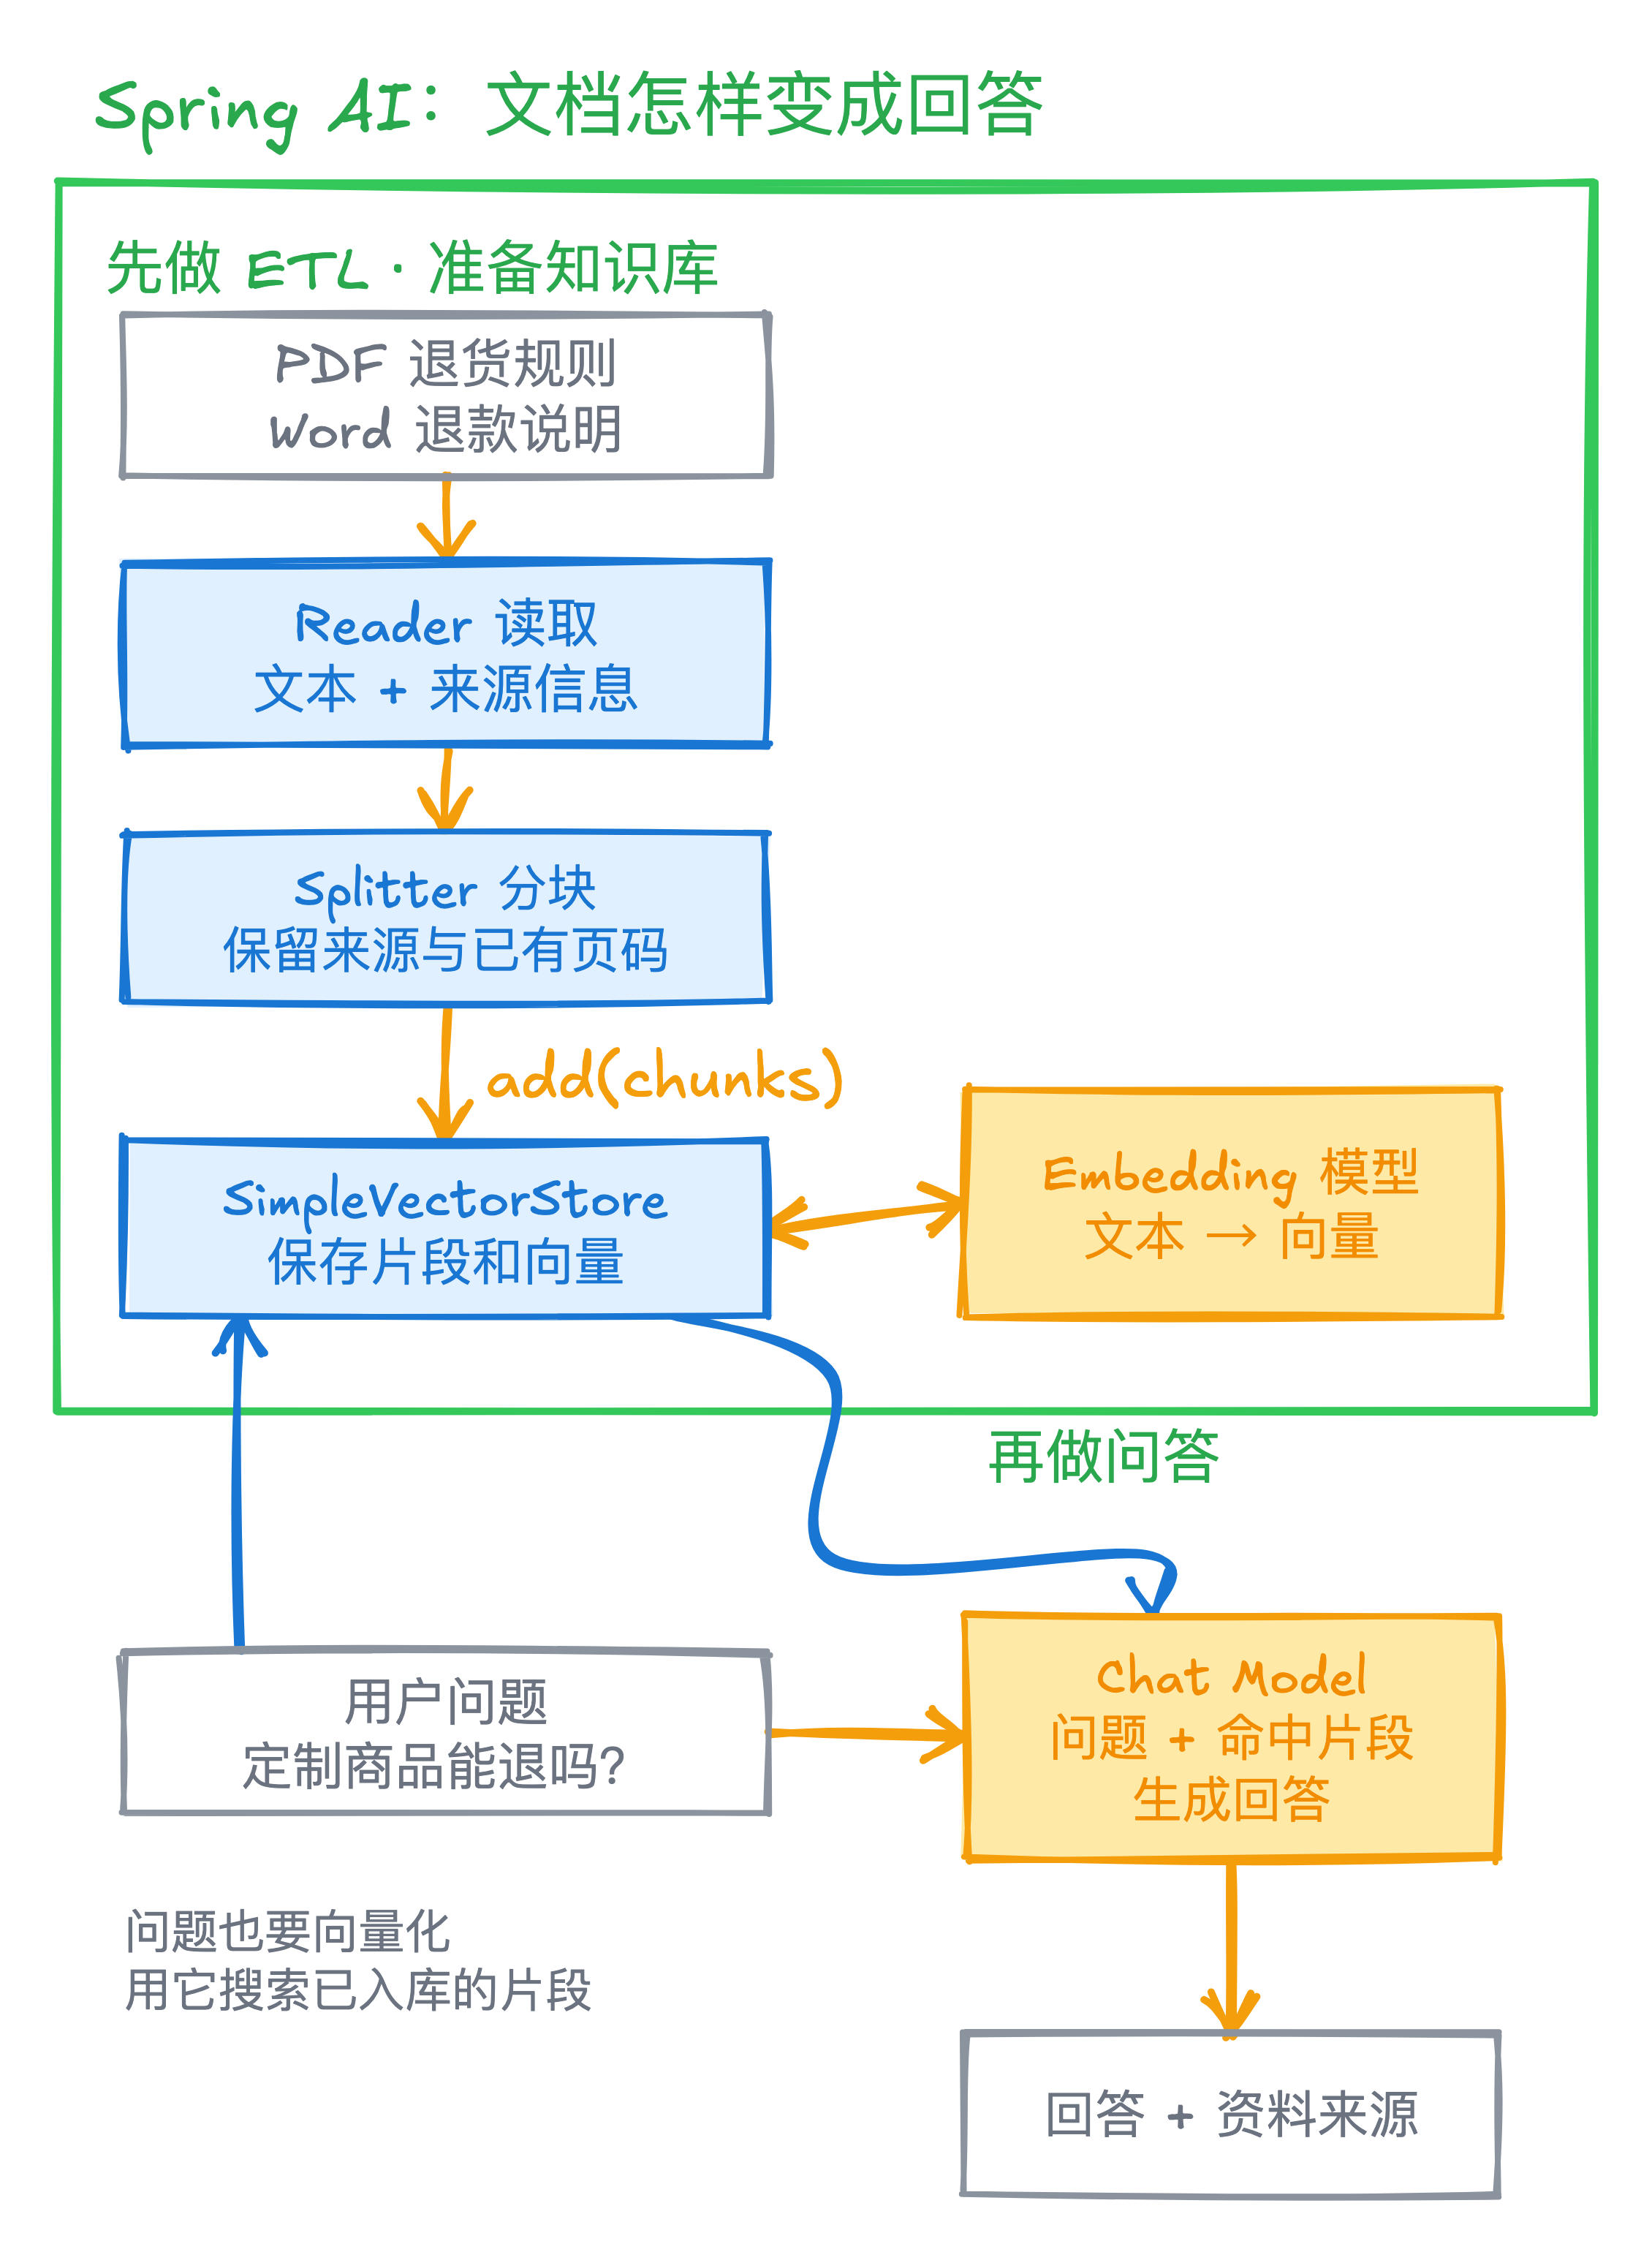
Spring AI 的 ETL 管道负责这段准备工作:读出文件内容、整理成片段,再写入向量存储。今天接入两份售后文档,最后用 Postman 提问,核对回答来自哪个文件、哪一页。
ETL 这三个字母,分别做什么#
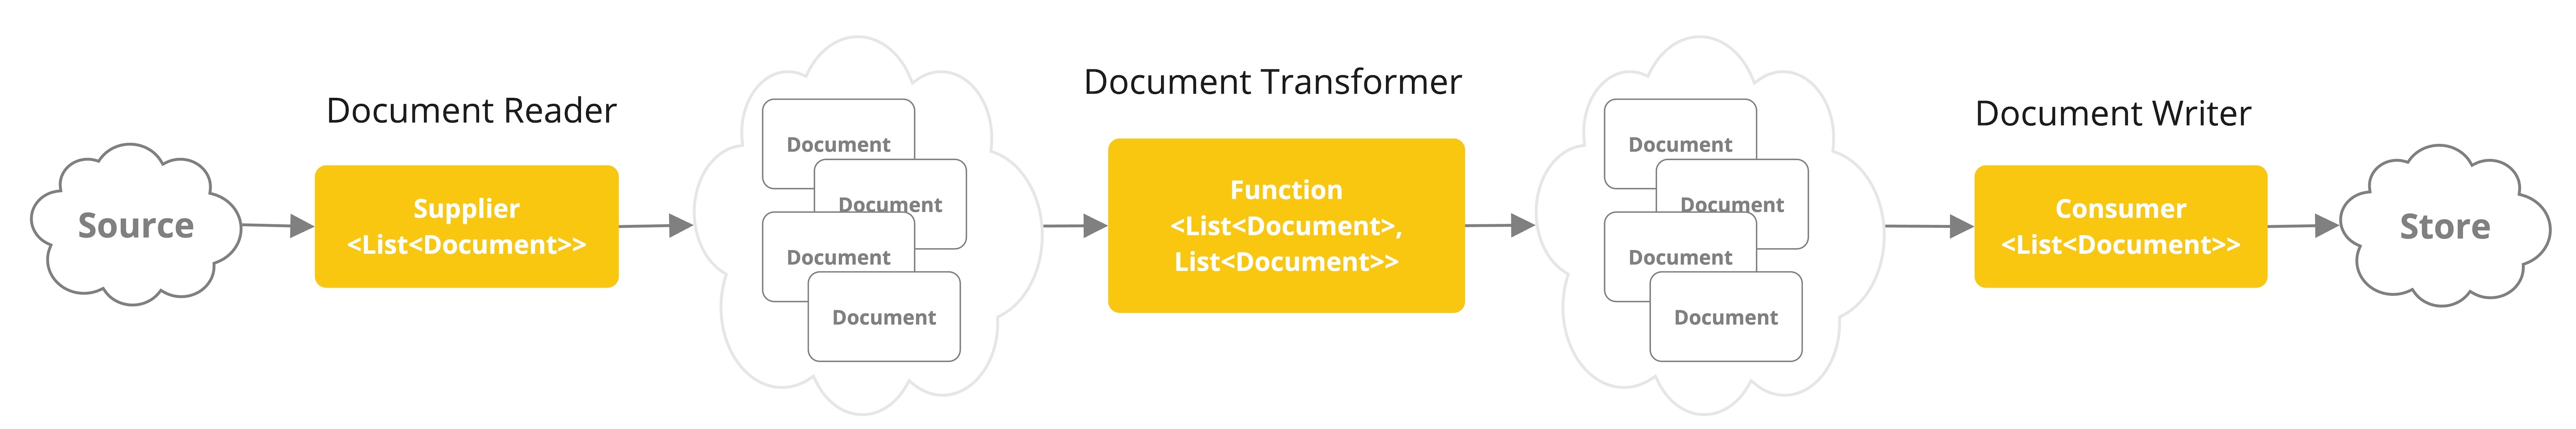
ETL 是 Extract、Transform、Load,也就是提取、转换、加载。Spring AI 官方把它分成三个接口:
| 接口 | 这篇让它做什么 |
|---|---|
DocumentReader |
从 PDF、Word 提取文字 |
DocumentTransformer |
把长文切成适合检索的片段 |
DocumentWriter |
将片段写入向量存储 |
三段之间传递的都是 List<Document>。这里的 Document 可以理解成一个 Java 数据对象,里面装着文本和元数据,例如文件名、页码。
这些接口在 Spring AI 1.x 已经存在。下面用 Spring AI 2.0.1 跑通整条链路。
先看准备入库的资料#
我编了两份商城售后演示文档,规则只用于这个示例:
| 文件 | 内容 |
|---|---|
returns.pdf,2 页 |
第 1 页普通退货;第 2 页定制商品退货 |
refunds.docx |
银行卡到账时间、银行卡注销、余额退款 |
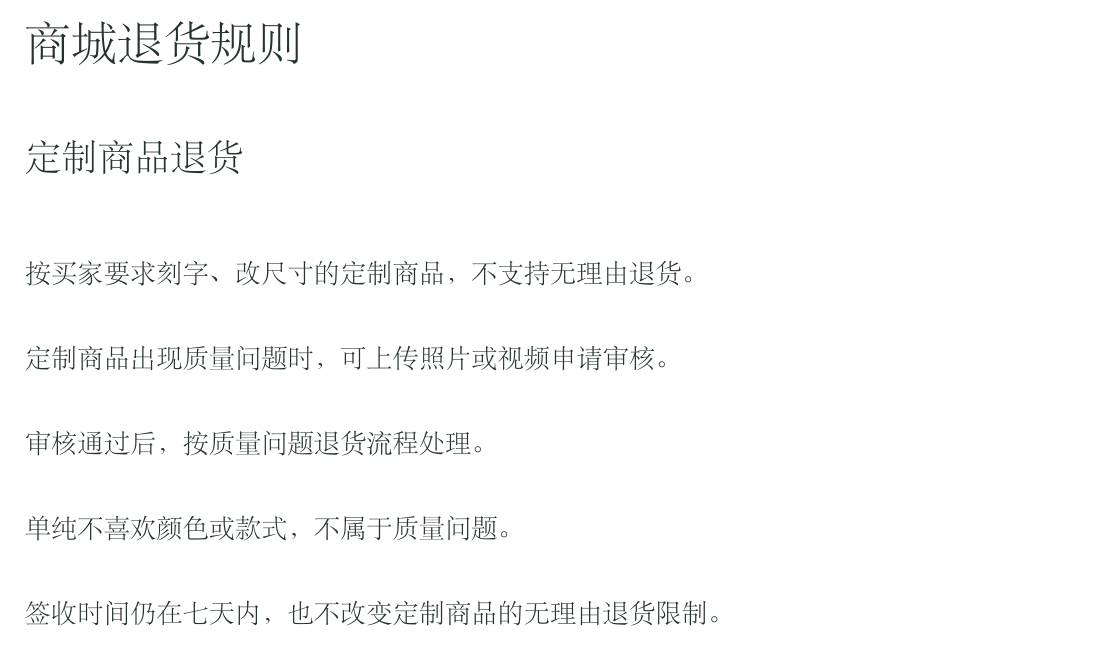
PDF 第二页专门写了一个例外:刻字、改尺寸的定制商品不支持无理由退货;出现质量问题,可以提交凭证申请审核。
整个示例分两段:先把文件准备成知识库,提问时再检索其中的片段。
两种文件,读成同一种对象#
PDF 使用 PagePdfDocumentReader,Word 使用基于 Apache Tika 的 TikaDocumentReader。对应依赖是 spring-ai-pdf-document-reader 和 spring-ai-tika-document-reader,版本由 Spring AI BOM 统一管理。
var pdfReader = new PagePdfDocumentReader(
    new ClassPathResource("docs/returns.pdf"),
    PdfDocumentReaderConfig.builder()
        .withPagesPerDocument(1)
        .withPageBottomMargin(65)
        .build());

var wordReader = new TikaDocumentReader(
    new ClassPathResource("docs/refunds.docx"));

var documents = new ArrayList<Document>();
documents.addAll(pdfReader.read());
documents.addAll(wordReader.read());
withPagesPerDocument(1) 表示每页生成一个 Document。底部留白配置用于跳过这份 PDF 的页脚,换文件时要按实际版式调整。
这两份文件读出来,一共是 3 个 Document:PDF 每页一个,Word 全文一个。
PDF Reader 带有 page_number 元数据;这里的 Tika Reader 没有提供 Word 页码。后续统一给文档补上 source 文件名,方便查询时回溯。
document.getMetadata().put("source", "returns.pdf");读取阶段先检查文字是否完整。带文字层的 PDF 可以直接走这条流程;扫描件需要先做 OCR,复杂表格也要单独检查提取效果。
切成片段,再交给向量存储#
var splitter = TokenTextSplitter.builder()
    .withChunkSize(180)
    .withMinChunkSizeChars(60)
    .withMinChunkLengthToEmbed(5)
    .withPunctuationMarks(List.of('。', '?', '!', ';', '\n'))
    .build();

var chunks = splitter.apply(documents);
var store = SimpleVectorStore.builder(embeddingModel).build();
store.add(chunks);
分块会保留原有元数据。调用 add 时,向量存储通过 Embedding 模型计算向量,同时保存片段文本与元数据。
这里使用本地 Qwen3-Embedding 0.6B,回答模型是 Qwen2.5 3B。SimpleVectorStore 用于内存演示,正式知识库可以换成 PgVector 等持久化实现。
在 Postman 中发送 POST /api/etl/import,读取项目里的这两份文件:
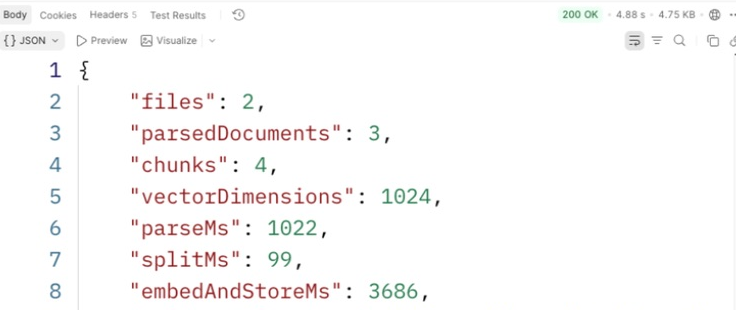
结果是 2 个文件 → 3 份文档 → 4 个片段,每个片段对应一个 1024 维向量。图中的毫秒数是这次本地运行的阶段耗时,文件量和模型环境变化后也会变化。
问一道需要区分规则的问题#
向 POST /api/etl/ask 发送:
{
  "question": "刻字的定制商品收到三天,不喜欢了,可以无理由退货吗?"
}
后端先取两个相关片段,再把片段与问题一起交给 ChatClient。提示词要求只依据资料回答,并保留适用条件和例外。
var hits = store.similaritySearch(
    SearchRequest.builder().query(question).topK(2).build());

var answer = client.prompt()
    .system("只依据提供的资料回答,保留适用条件和例外。")
    .user("资料:\n" + context + "\n问题:" + question)
    .call().content();
context 是命中片段的文本及来源拼接结果;上面省略了拼接代码和回答长度约束。
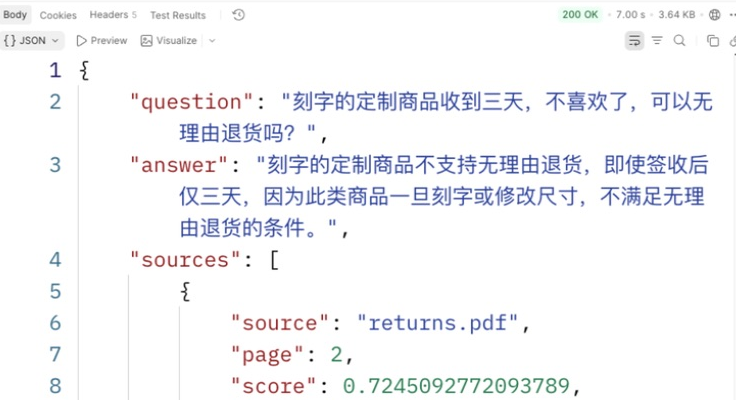
这次回答明确说了“不支持无理由退货”,没有套用普通商品的七天规则。展开 sources,第一条就是 returns.pdf 的第 2 页。
再问银行卡注销,核对 Word 是否也能检索到:
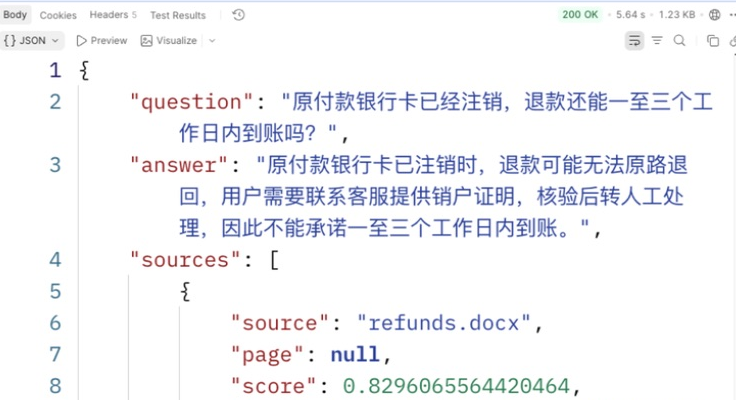
回答保留了“提供销户证明、核验后转人工处理、不能承诺一至三个工作日到账”这几个条件。
sources 由后端根据检索结果附上,方便对照原文;它并不代表每句话都已经完成事实校验。两个接口也是演示项目的入口,读取、分块和向量存储用的是 Spring AI 组件。
到这里,PDF、Word 已经走完了读取 → 分块 → 向量化 → 检索问答。后面换成更多业务文档,可以沿用这套结构,先把解析内容和来源信息核对清楚,再扩大入库量。
我会持续更新 Spring AI 实战教程,感兴趣的朋友可以关注我。我是一言,下篇见。