大家好,我是一言。
上一篇用 Modular RAG 解决了一句话中出现多个问题的情况。这次来看多轮对话中的追问。
用户连续问问题时,经常会省略前面说过的信息。比如上一句还在聊银行卡退款,下一句就只问“那多久到账?”。
RAG 在回答前要先查知识库。如果只拿这句追问去搜索,就容易把退款和提现的资料混在一起。
这时可以先结合聊天历史,把追问补成完整的问题,再去检索。Spring AI 的 CompressionQueryTransformer 就负责这一步。下面用订单取消的例子,跑一遍改写前后的区别。
先看一次接不住的追问#
第一轮的问题是:
这笔银行卡支付的订单还没发货,现在不想要了,可以取消吗?
模型查到了取消规则,回答:
可以的,您可以在订单处于“待发货”状态时申请取消,取消成功后货款将按原支付方式退回。
接着问:
那多久到账?
它却回答:“知识库中暂时没有相关说明”。
明明有退款资料,上一轮也已经说到退款了,为什么还接不住这句追问?
我把这段对话在本地跑了一遍。使用 Spring AI 2.0.1、Qwen2.5 3B 和 Qwen3 Embedding 0.6B,知识库里只有三份演示规则:
| 文件 | 规则 |
|---|---|
order-cancel.md |
待发货订单可以取消,货款原路退回 |
refund-arrival.md |
银行卡退款通常需要 1~3 个工作日 |
wallet-withdrawal.md |
余额提现到银行卡通常需要 24 小时 |
退款和提现都会提到“到账”,在搜索的时候需要区分用户问的是哪一种。
这个组件放在哪一层#
先来看一下加入查询改写之后的连接方式。RetrievalAugmentationAdvisor 会把改写、检索和上下文组装串在一起:
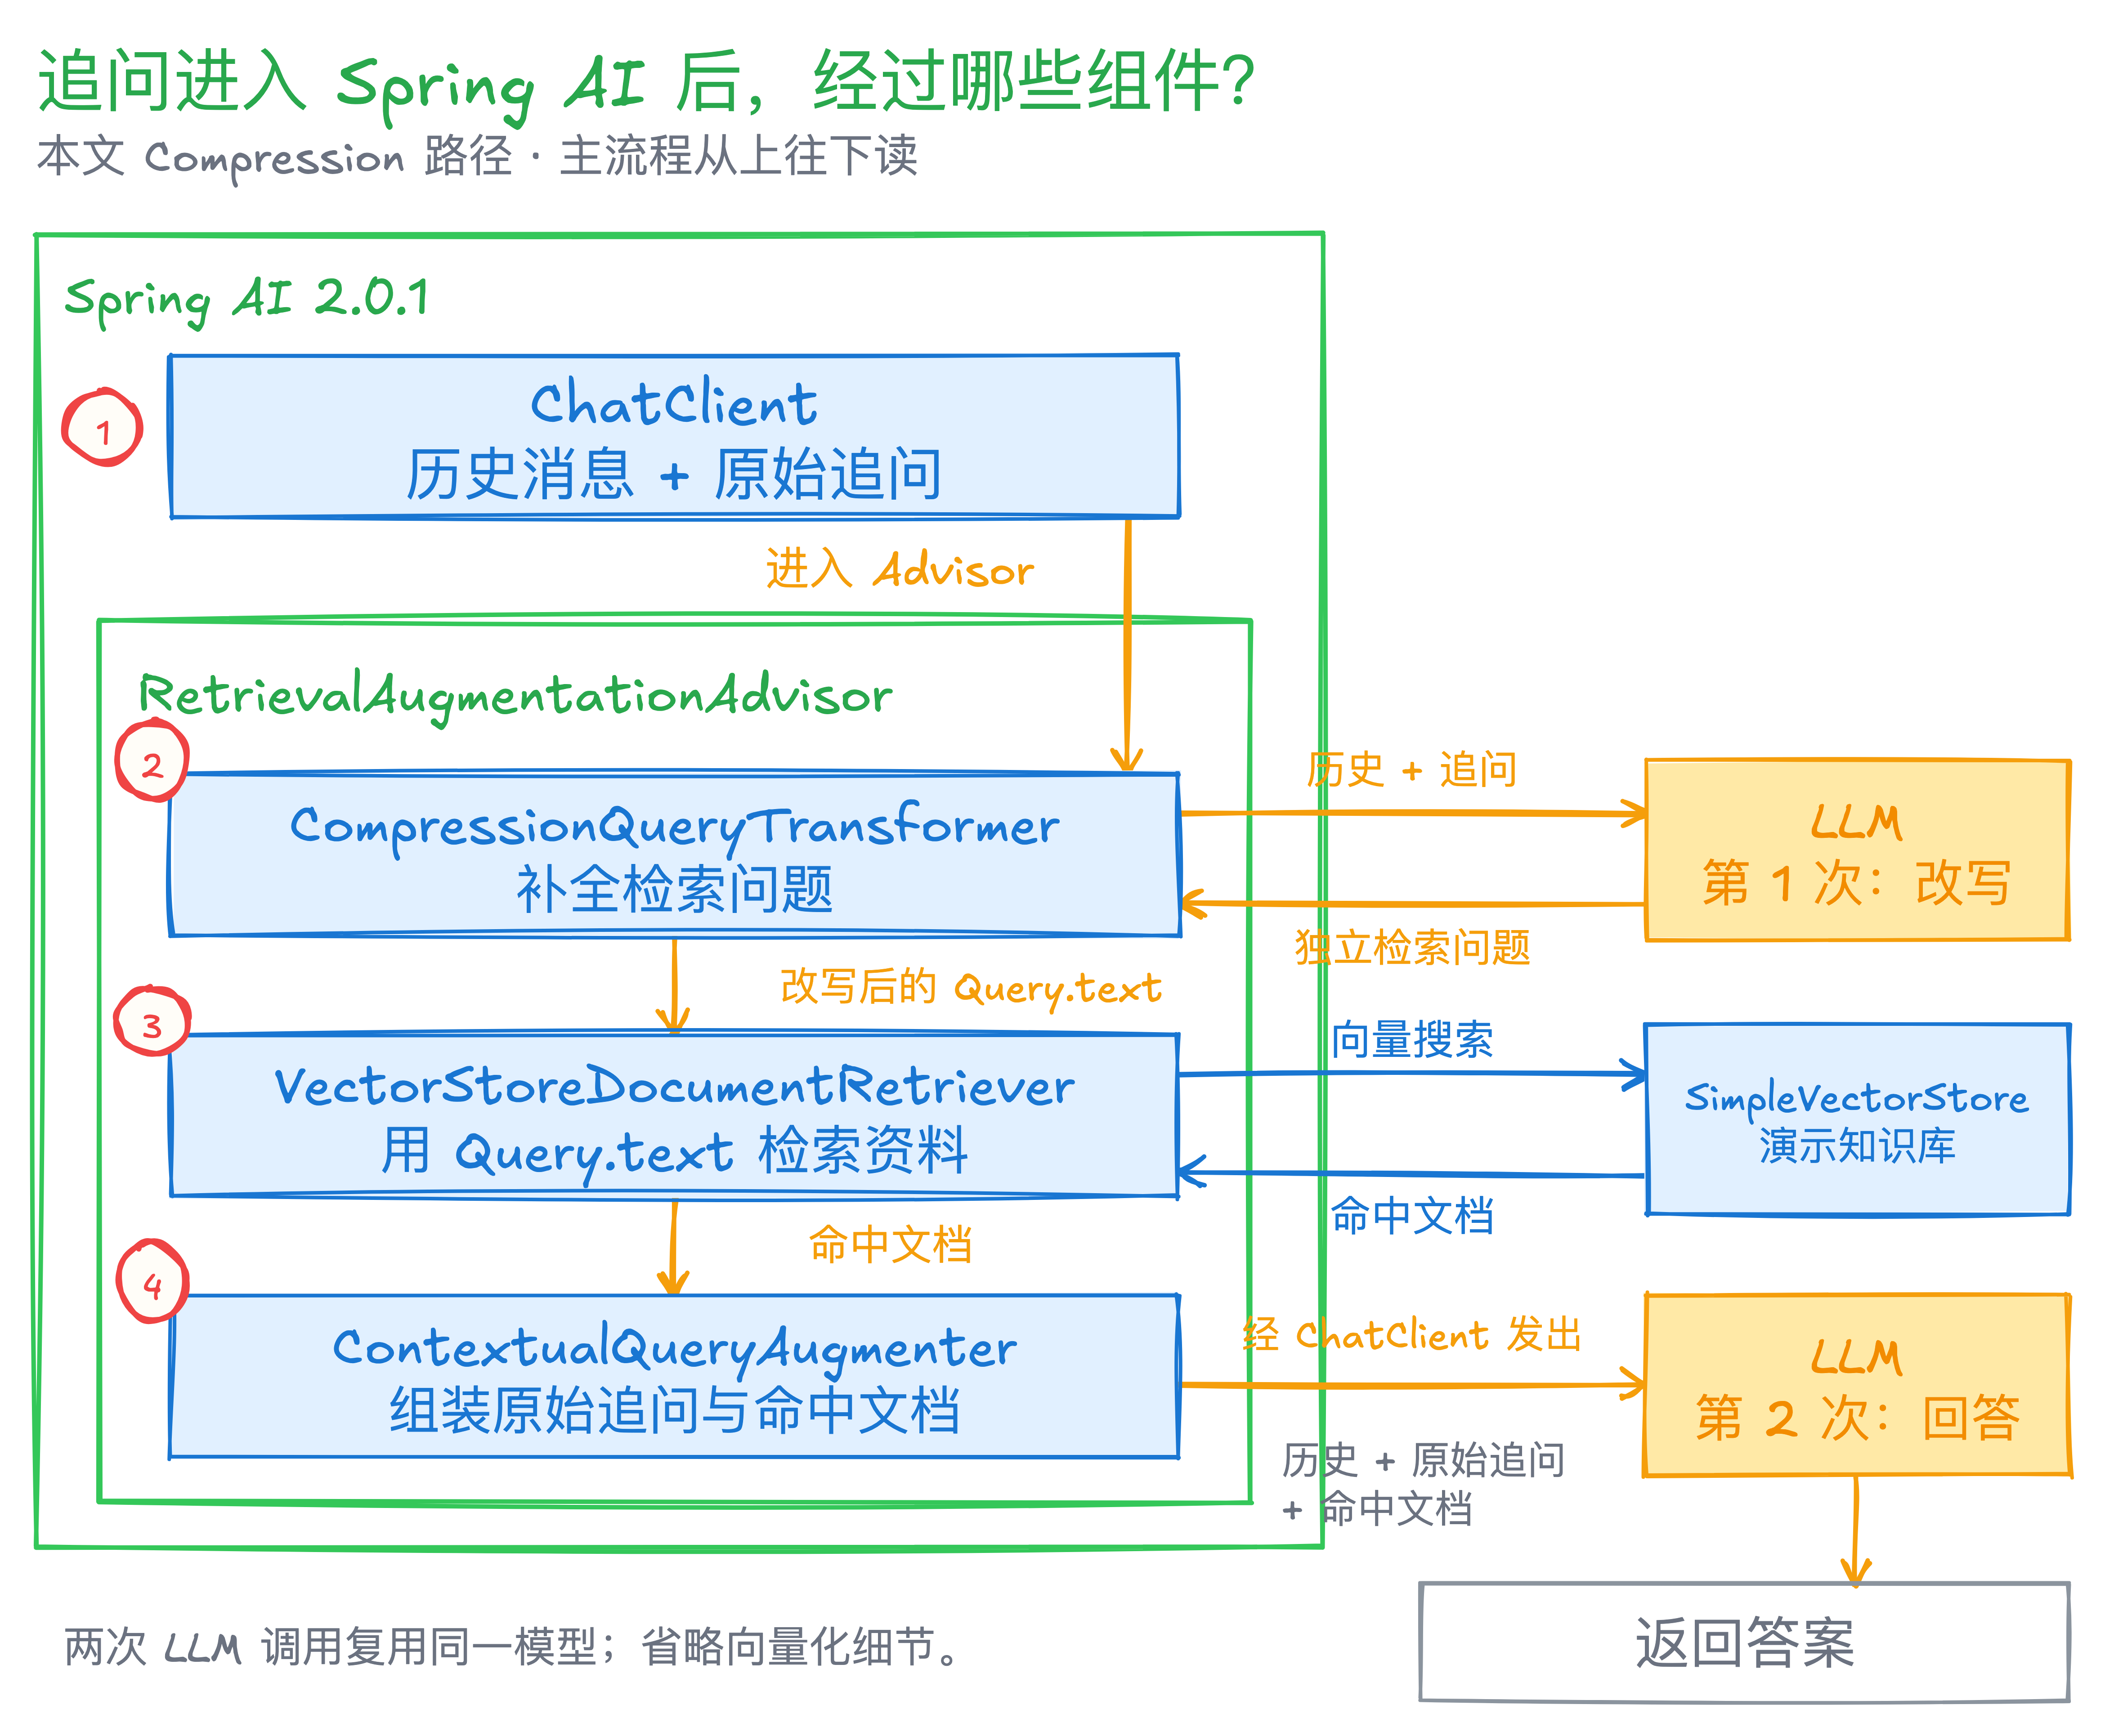
沿左侧从上到下读:先补全检索问题,然后查找资料,最后把资料装进回答请求中。右边的两个黄色框表示同一个模型会被调用两次,一次用来改写,一次用来回答。
Direct 路径会跳过查询改写。先跑一次 Direct,看看它为什么接不住这个追问。
从检索词定位问题#
先看历史消息有没有传进来。这次用 .messages(...) 显式地把第一轮对话传进去,firstAnswer 就是前面真实模型返回的回答:
String answer = ChatClient.builder(chatModel)
        .build()
        .prompt()
        .messages(
                new UserMessage(firstQuestion),
                new AssistantMessage(firstAnswer))
        .user("那多久到账?")
        .advisors(directAdvisor)
        .call()
        .content();
这里的 directAdvisor 接收检索器和上下文组装器,直接对当前问题进行检索,不做改写。向量库使用 SimpleVectorStore,topK=1、similarityThreshold=0.0。
我在检索器入口记录了 Query。下面是 IDEA 中的运行截图,重要日志也摘在图后:
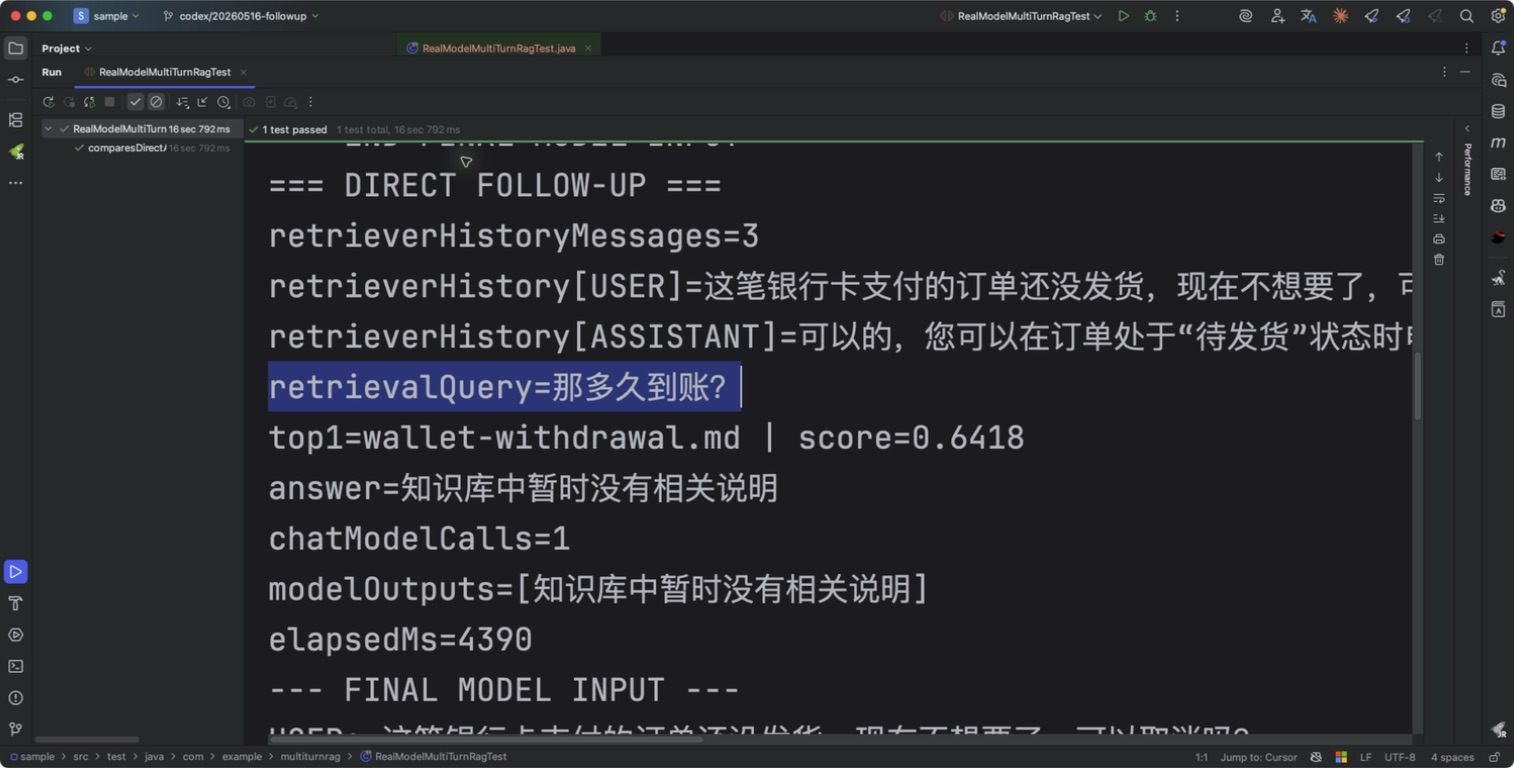
retrieverHistoryMessages=3
retrievalQuery=那多久到账?
top1=wallet-withdrawal.md | score=0.6418
answer=知识库中暂时没有相关说明
历史消息已经传进来了:前一个问题、模型的回答、现在的追问,一共 3 条信息。但是 Query.text 仍然只有“那多久到账?”这一句,Top 1 命中了 wallet-withdrawal.md。
看一下 VectorStoreDocumentRetriever 创建搜索请求时的关键一行:
.query(query.text())向量搜索使用的是 Query.text。虽然 Query.history 带着历史,这个检索器并没有把历史拼进搜索词里。
这就解释了本次的现象:回答模型看到了前面的内容,但是搜索的时候缺少“银行卡退款”这个对象,拿回来的结果是提现资料。最后模型输入的内容也被记录在日志里,其中确实包含上一轮对话以及这份提现规则。
要补的是检索之前的第一步:结合历史,把“那多久到账?”写成一个可以独立搜索的问题。
在搜索之前补全问题#
主要配置是 .queryTransformers(transformer),它会把查询改写放在向量检索之前。装配代码如下:
var transformer = CompressionQueryTransformer.builder()
        .chatClientBuilder(ChatClient.builder(chatModel))
        .promptTemplate(compressionPrompt)
        .build();

var compressionAdvisor = RetrievalAugmentationAdvisor.builder()
        .queryTransformers(transformer)
        .documentRetriever(retriever)
        .queryAugmenter(queryAugmenter)
        .build();
compressionPrompt 是本次测试使用的中文模板。它要求模型结合历史补全追问,保留支付方式和退款动作,只输出完整的检索问题。模板里的 {history} 接收历史,{query} 接收当前追问。
retriever 和 queryAugmenter 仍然使用原来的参数。调用处改成 .advisors(compressionAdvisor),然后再问一次“那多久到账?”。
补全以后,查到了什么#
两组使用的是相同的首轮历史、同一个知识库以及一样的回答 Prompt。IDEA 中另一组的结果如下:
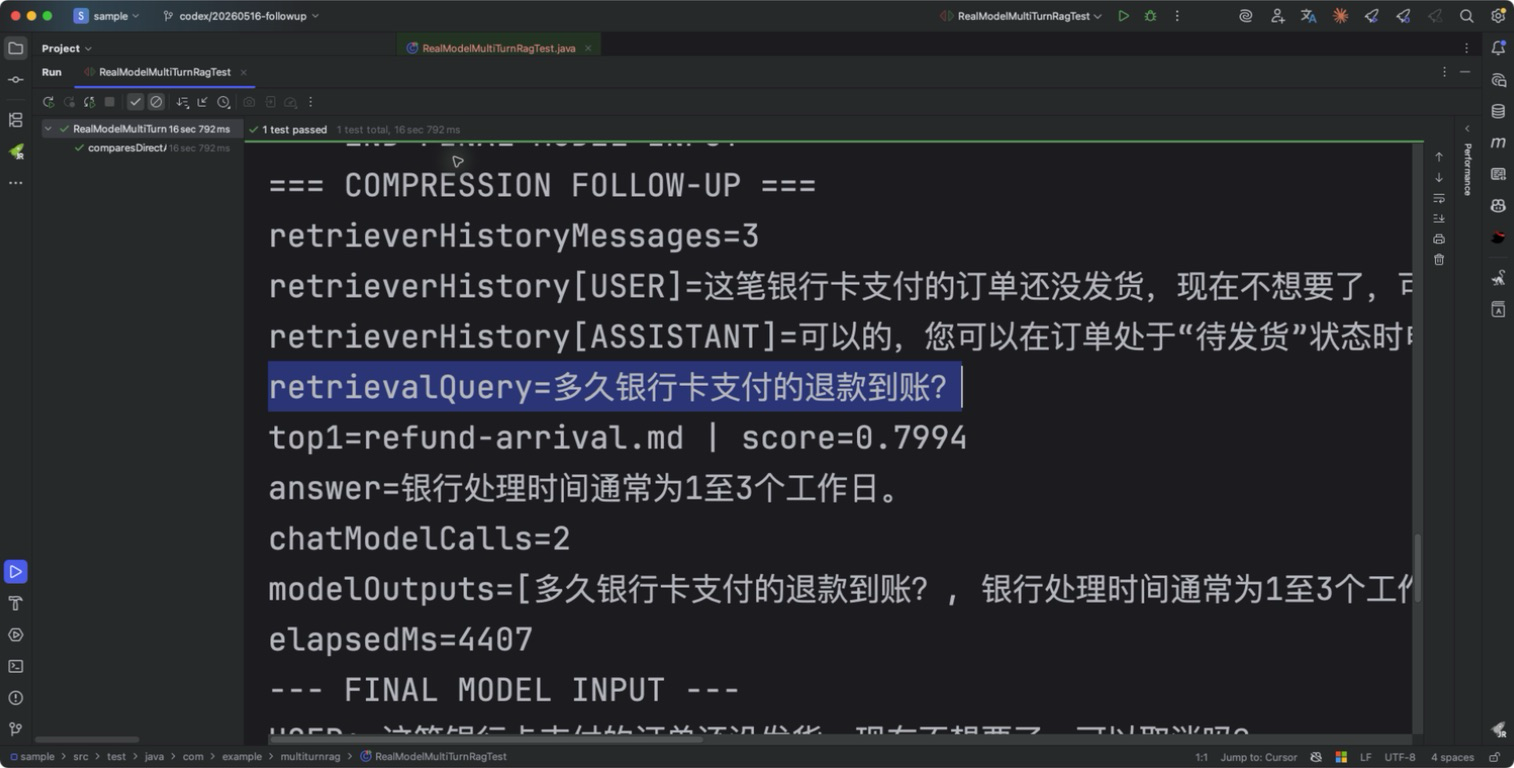
retrievalQuery=多久银行卡支付的退款到账?
top1=refund-arrival.md | score=0.7994
answer=银行处理时间通常为1至3个工作日。
改写后的句子补上了“银行卡”和“退款”,检索命中了退款规则,回答也给出了到账时间。
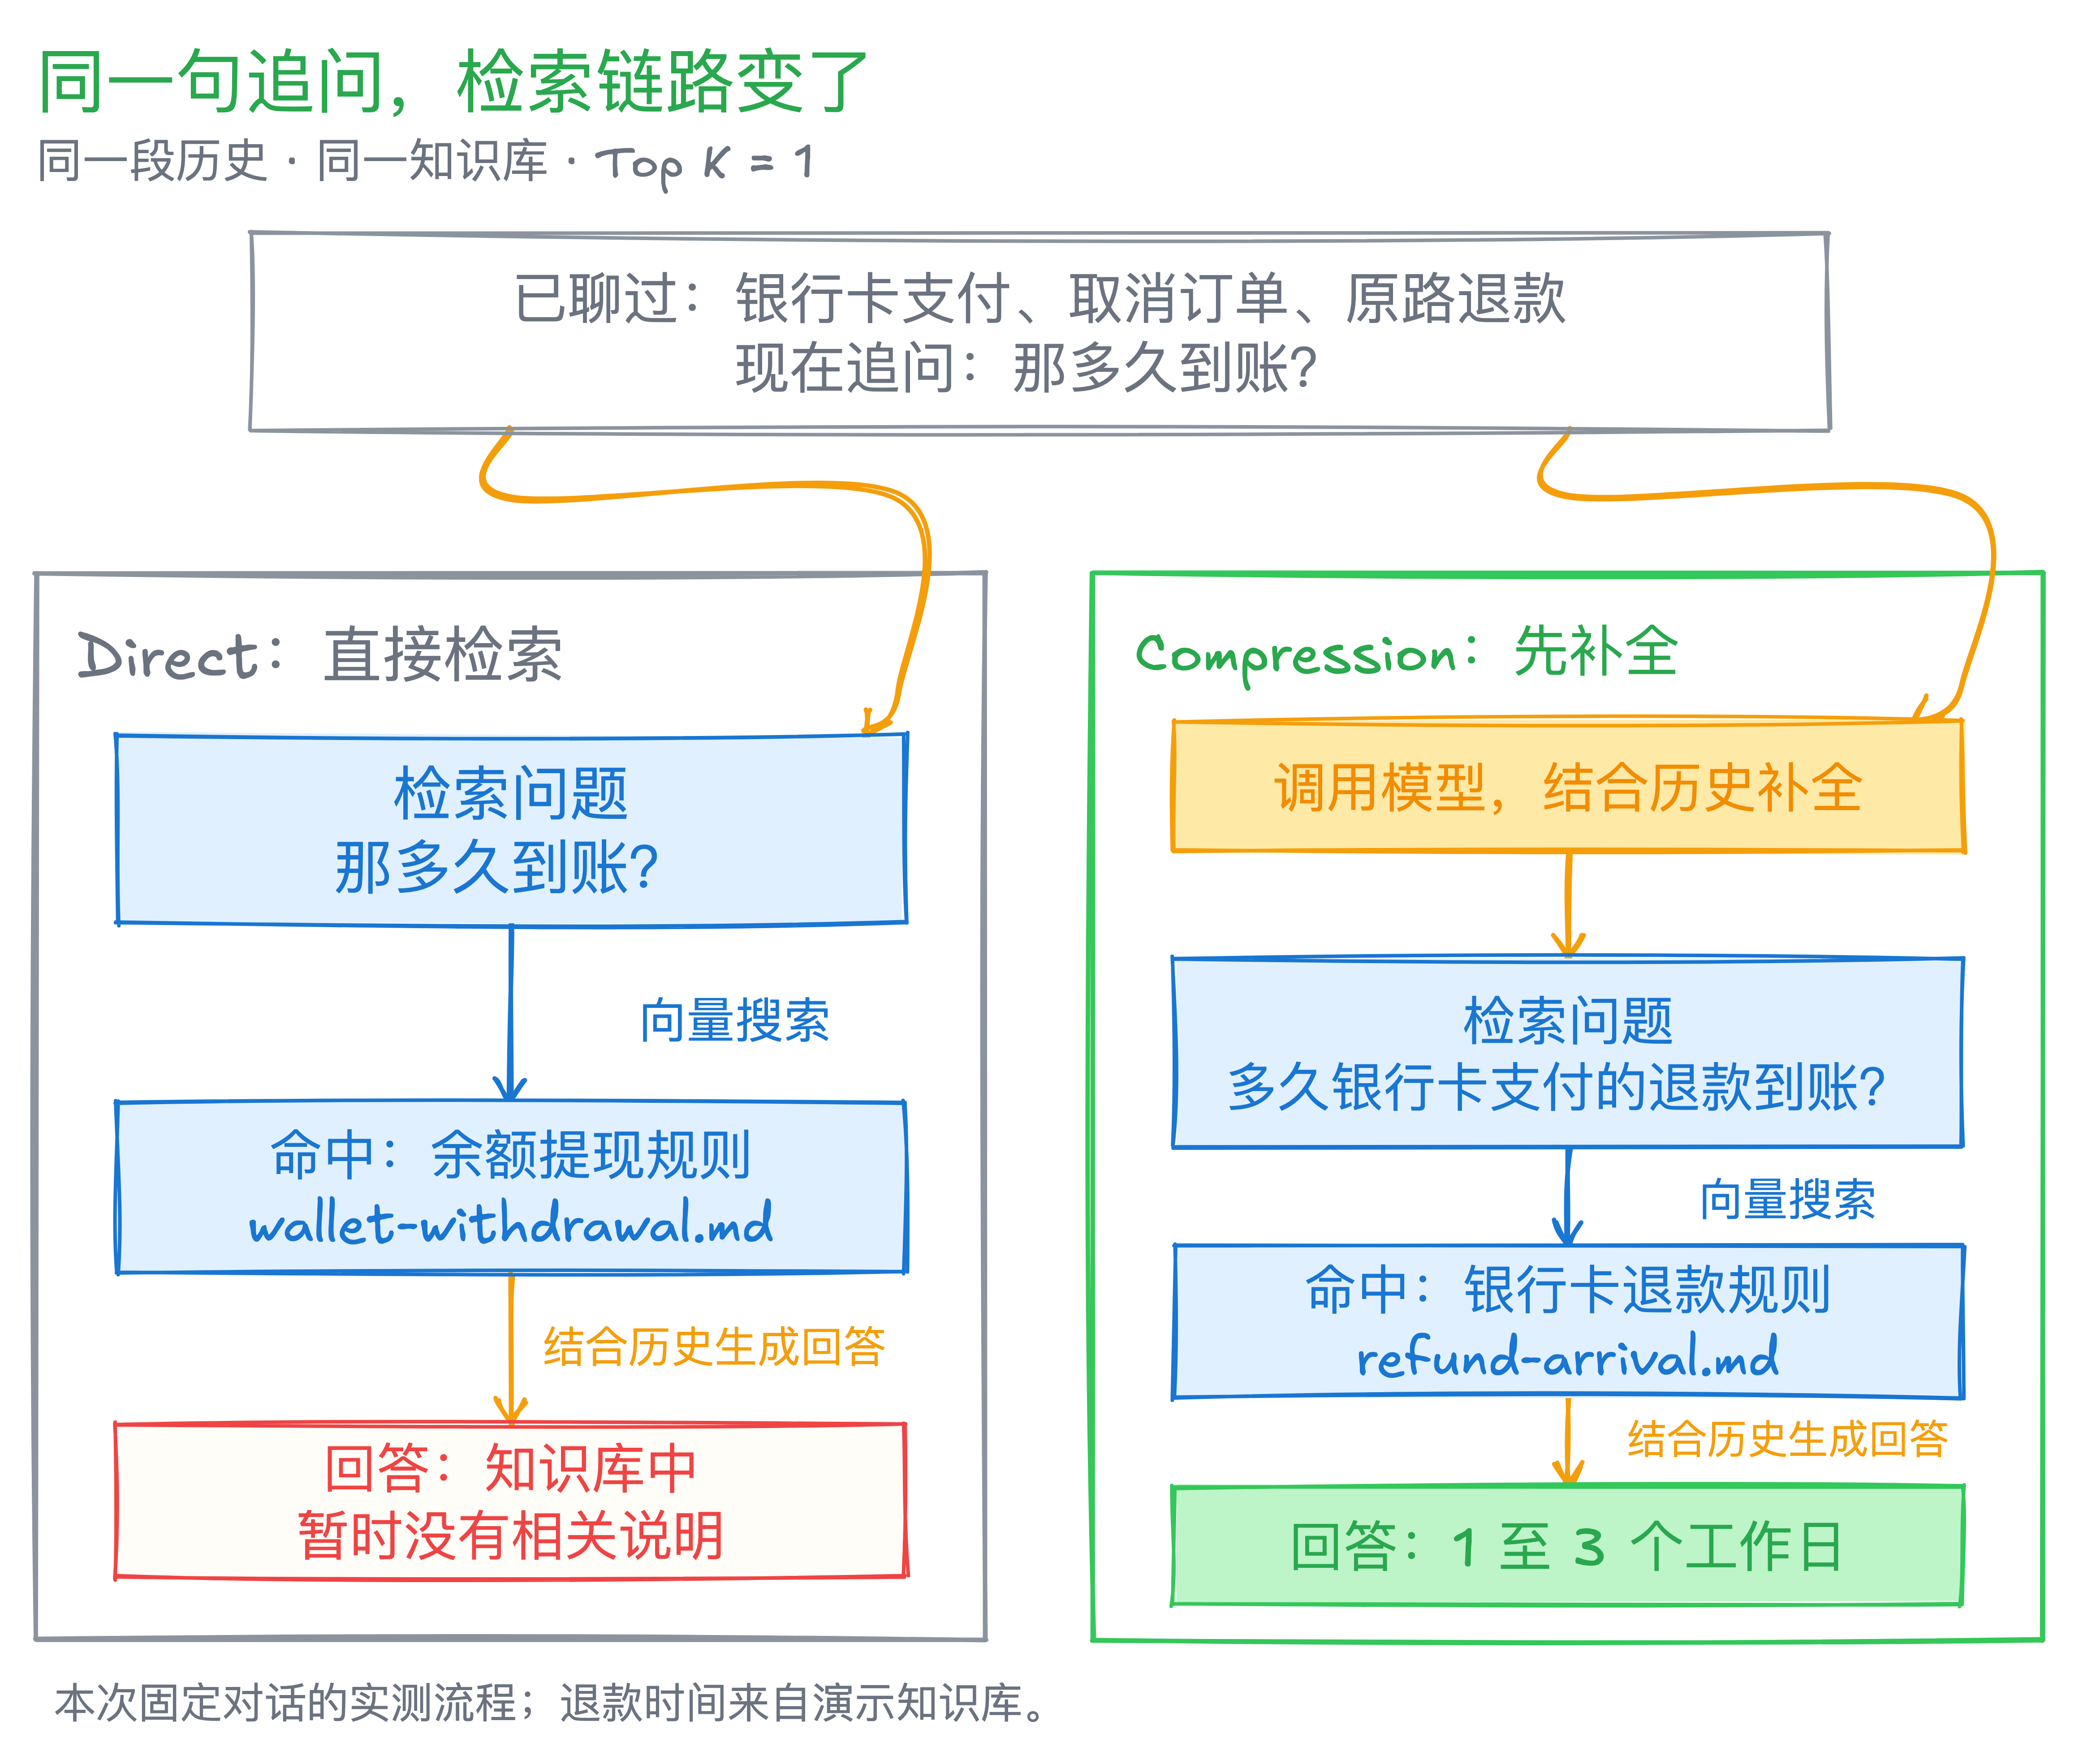
本次 1 个真实模型集成测试已经通过,对历史消息、检索查询、命中文档以及最终回答都进行了检查。
改写之后的问题用来检索。生成答案的时候,模型仍然会收到原始追问、历史以及命中文档。
这次修改有什么用#
知识库、检索参数以及回答 Prompt 都没有发生变化。我们只在检索之前加入了 CompressionQueryTransformer,让模型利用聊天历史补全追问,然后再交给向量库进行搜索。
原来搜索的只有“那多久到账?”,退款和提现都可以匹配。加上这一步之后,检索问题带上了前文的“银行卡退款”,这次就找到了退款规则。
它解决的是多轮问答中“用户省略了前文信息”的问题。用户可以顺着上一轮继续提问,系统会把省略的信息补充到检索问题里,从而减少查错业务资料的情况。
本例中模型被调用了两次:一次用来改写问题,另一次用来生成答案。它可以帮助系统找准知识库里已经存在的资料;